Web MOOC 1
Internet > WEB MOOC
Encontrando tesoros en la red
"Si bien buscas, encontrarás", expresaba Platón, y nosotros podemos agregar: "Si bien filtras, encontrarás información verdaderamente valiosa en la Red; te permitirá enriquecer tus producciones que luego podrás compartir".
BIENVENIDOS a este espacio en el que iremos plasmando las actividades del MOOC "Encontrando tesoros en la Red".
Mi nombre es Miguel, un viejo autodidacta de TIC, desde que un fatídico día (en los primeros años 80) conocí las extrañas palabras BASIC y MS-DOS. Han habido muchas etapas en el tiempo transcurrido, y hoy me encuentro frente a un blog creado para crecer en el conocimiento, y aprender a poner orden en todo el bagaje acumulado.
Presentación
He optado por ubicar mis colaboraciones optativas en el menú de cabecera.
Al iniciar esta actividad abruma un poco la inmensa variedad de elementos, herramientas, disposiciones, efectos, etc... que se pueden ir combinando a la hora de transformar la estructura del mensaje, y cada uno de ellos era necesario ir explorándolo sobre la misma (al final creo que eché en falta la inserción de música), y será necesaria la elaboración de varios documentos para conocer a fondo las posibilidades que encierra.
En esta ocasión, he incluído varios enlaces, efectos de edición y de transición, y he dejado habilitada la inserción de comentarios en la misma Presentación, que comparto en los siguientes enlaces.
WEB Semántica
Curso impartido por Marcelo Arenas, profesor en el Departamento de Ciencias de la Computación de la Pontificia Universidad Católica de Chile, y Carlos Buil profesor en el Departamento de Informática de la Universidad Técnica Federico Santamaría.
¿Cómo es la web actual? ¿Cuántos millones y millones de páginas web existen? La web actual es masiva, cambiante y heterogénea, si consideramos los millones de dispositivos diferentes que generan datos. Además es distribuida, pues es un gran repositorio de información al cual todo el mundo puede acceder, desde cualquier parte.
¿Pero es realmente accesible esta información? Hoy en día tenemos buscadores y otras herramientas que nos facilitan el acceso a los datos; pero estas herramientas miran las páginas web como si fueran conjuntso de palabras, y no son capaces de entender o tienen dificultades al momento de entender los distintos elementos que forman parte de ella, dispositivos, personas, lugares geográficos, publicaciones, películas etc..., y sobre todo tienen dificultades al momento de entender las relaciones que existen entre estos elementos.
En este curso veremos en que consisten las tecnologías de la Web Semántica y como se utilizan en la web actual. También realizaremos varios proyectos aplicando todas estas tecnologías para resolver los problemas que tenemos actualmente. Por ejemplo, ¿le gustaría que si usted tiene una tienda virtual, Google fuera capaz de identificar los distintos productos de su tienda virtual y los desplegara al momento de hacer una búsqueda? Esto se consigue usando schema.org y les mostraremos como se relaciona en este curso con las tecnologías de la Web Semántica. Además, ¿le gustaría poder acceder a la Wikipedia como si fuera una tabla Excel? ¿O conocer cómo han hecho los gobiernos para hacer públicos sus datos y de esta manera permitir que los ciudadanos tengan acceso a la información de cómo se gastan sus impuestos, o puedan entender de una manera más sencilla como le afecta una ley? ¿O saber cómo hacen los biólogos para compartir sus datos en la web?
Muro Tesoros WEB
Infoxicación - ¿Qué es?
El exceso de información existente en Internet es un fenómeno que afecta a todos los usuarios de Internet en mayor o menor medida, fruto de la desestructuración innata e incontrolable, que abarca informaciones duplicadas (en distintos idiomas, proliferación de CopyPaste, indexación de motores, etc...), información fragmentada ó ampliada ubicada en diferentes lugares, personalización ó libre interpretación que en ocasiones realizamos sin la debida verificación, desinformación interesada,...
Para analizar debidamente este problema, ya en 1970 Alvin Toffler acuñó la expresión “sobrecarga informativa” (information overload) en su libro “Future Shock”, y Alfons Cornella (fundador y presidente de Infonomía) introdujo en 1996 el término Infoxicación, amalgama de las palabras información e intoxicación, evidenciando lo poco que sabemos acerca de qué es la información y sobre cómo manejarla. Otros autores afirman que la infoxicación es la enfermedad de la sociedad digital de principios del siglo XXI, impulsada por Google, las redes sociales, y más recientemente la Internet de las cosas, llegando a causar sensación de angustia y frustración de no poderla abarcar ni gestionar y, por tanto, llegar a generar una gran angustia.
Este último fin de semana de Septiembre hemos asistido al Agotamiento de las direcciones IPv4 en los registros para América (ARIN), y estamos próximos a que suceda lo mismo en Europa (RIPE). Estaríamos hablando de unos 4.000 millones de direcciones IP, que con mayor ó menor acierto manejan los motores de búsqueda en Internet. Todo un exceso información, que nos puede paralizar ó frenar nuestro avance hacia los objetivos que nos hemos propuesto, por mera saturación informativa.
Este último fin de semana de Septiembre hemos asistido al Agotamiento de las direcciones IPv4 en los registros para América (ARIN), y estamos próximos a que suceda lo mismo en Europa (RIPE). Estaríamos hablando de unos 4.000 millones de direcciones IP, que con mayor ó menor acierto manejan los motores de búsqueda en Internet. Todo un exceso información, que nos puede paralizar ó frenar nuestro avance hacia los objetivos que nos hemos propuesto, por mera saturación informativa.
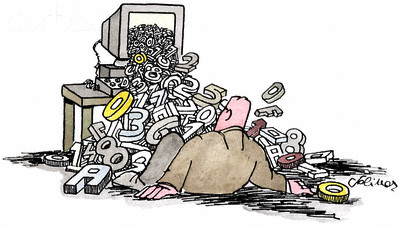
Así pues, debemos aprender a controlar el flujo de informaciones. Debemos aprender que Google no es una fuente, ni el autor de la información. Cuando buscamos información en Google nos devuelve cientos de miles de resultados, repetidos, en múltiples idiomas, no contrastados, etc... Son miles de impactos informativos que no tenemos capacidad de procesar, ante los que reaccionamos de distintas maneras. Es habitual hacer una lectura rápida y superficial del material, la información “vuela” o satura nuestra capacidad de digerirla con un resultado nulo. En otras ocasiones preferimos acumular la información que nos parece relevante para “leerla más adelante”. Nuestros ordenadores o archivadores se llenan de páginas y páginas a las que seguramente nunca volveremos. “Sufrimos una especie de Síndrome de Diógenes informativo”.